從混亂的設計稿
到可查詢的設計圖譜
一個把 Figma AST 抽成 SQLite、讓設計師能用 ID 與分類複審、讓 agent 能直接查詢的本地工具鏈。
00起點:一個被工程細節吃掉的工作日
這個專案不是從技術開始的,是從一個真實的工作日開始的。
那天的工作是「把支付結果頁整理出來」:找出成功、失敗、處理中三種狀態,確認哪幾張是重複的,再跟舊版比對差異。聽起來是設計工作,實際上大半時間花在翻頁、對圖層名稱、開兩個視窗比對、把截圖貼進簡報、發現漏了一張再重來。
UX 設計師本來就該有設計工程化的思維——理解結構、命名、狀態、元件邊界。但「工程化」這件事本身是瑣碎的,而且極容易出錯:漏一頁、貼錯 ID、把舊版當新版。這些錯誤不會被發現,只會在下一次評審時變成一句「這頁怎麼沒更新?」
所以我們做了一個工具:把混亂的部分(抽取、去重、比對、分類)工程化一次,讓設計師回到真正擅長的事——看著 ID 和畫面,說「這張不對」。
01設計稿的現實
一個跑了兩年的支付產品設計檔,會長成這樣:
- 13 個頁面、163,601 個節點——單一檔案
- 390×844 的畫面 512 個,去重後實際只有 291 個(43% 是複本)
- 設計師常用的名稱只有 27 種,但背後有 68 種不同結構
- 15 個名稱對到多種結構,最糟的一個名稱涵蓋 9 種結構
這不是某個團隊的失誤,是設計工具的工作方式:Figma 最佳化「畫」,沒有最佳化「查」。
02設計師要回答的問題
在真實的工作裡,設計師與 PM 反覆要回答這幾題:
這個頁面還有哪些狀態?成功、失敗、處理中分別長怎樣?
這批畫面哪些是複本?32 個同名頁面裡,真正不同的是哪幾張?
新舊版差在哪?是換了設計語言,還是只改了文案?
這三題在 Figma 裡都只能人工翻頁、肉眼比對。512 個畫面,一個人一天看不完,而且看完也無法沉澱成可重複使用的結論。
03為什麼現有工具不夠
| 做法 | 卡在哪 |
|---|---|
| Figma 內建搜尋 | 只搜名稱;名稱不可靠時完全失效 |
| Figma REST API | 需要 token 與雲端往返;拿不到 plugin 執行期的 mainComponent、變數綁定等資訊 |
| 人工看圖 | 可行,但不可重複、不可累積,換一個人就要重來 |
| 視覺模型直接看圖 | 成本高、不可審計;而且「這頁有幾個節點、用哪些 token」它算不準 |
缺的其實不是「更聰明的模型」,而是一個能讓人和 agent 一起查詢的中間層:資料要落地、查詢要精確、判斷要能被人覆寫。
04我們的做法
三個原則貫穿整個設計:
- 一次抽取,無限查詢。AST 只抽一次(約 16 萬節點),之後所有問題都問本地圖譜,不再回頭開 Figma。
- 能算的就不要猜。結構用樹 hash、版面原型用 z-order 規則、風格用色票與字階統計——全部可驗證、可重跑。
- 人的判斷是最後一層。模型只給候選與信心,最終分類由設計師在網頁上打勾,資料再由工具寫回。
05成效
更重要的是:這些結論可以被下一個人重跑。不是一份簡報,是一條能重複執行的流程。
以下數字來自一份真實生產檔案(支付產品,163,601 個節點),不是合成資料。
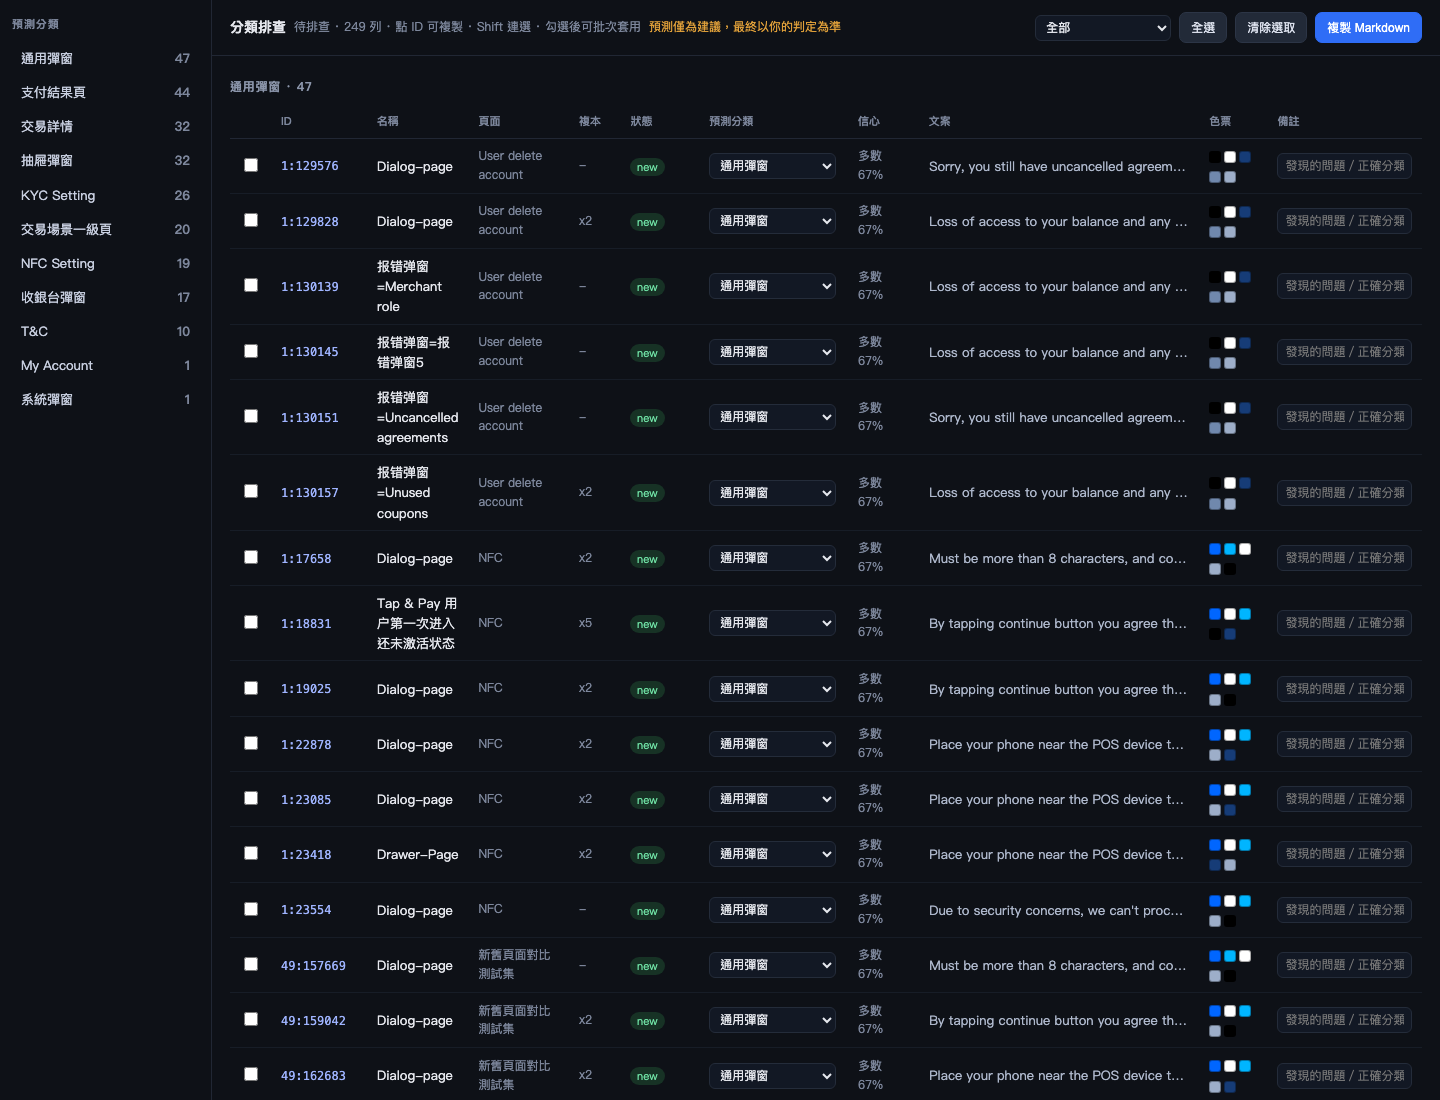
實驗方法
| 方法 | 做法 | 結果 |
|---|---|---|
| 全量抽取 | 不抽樣,以 SYNC_COMPLETE 與節點數對帳 | 163,601 / 163,601 一致 |
| 人工標註 | 設計師標 42 個畫面的分類與新舊世代 | 作為 ground truth |
| 實地抽查 | 隨機 10 個節點,設計師在 Figma 逐一比對 | 10/10 一致 |
| 留一驗證 | 每次拿掉一個標註,用其餘預測它 | 整體 57%,全票 86% |
| 冷啟動測試 | 新 agent 只讀 SKILL.md,執行完整流程 | 兩輪,修掉 15 個文件缺口 |
06整體架構
四層,每一層只有一個責任:
Figma 文件
  │  figma.* API(QuickJS sandbox,無網路)
  ▼
plugin/src/code.ts        遍歷節點、序列化、500 筆一批
  │  postMessage(唯一的跨沙箱通道)
  ▼
plugin/ui.html            iframe:只有 WebSocket,沒有 figma.*
  │  ws://127.0.0.1:8765
  ▼
server/ws-server.ts       驗證訊息、每批一個 transaction
  │
  ▼
data/rea-figma.sqlite     nodes / pages / components / variables / file_meta
  │
  ▼
server/core/*             純函式:結構 hash、風格指紋、分類、變體軸
  ├── server/query.ts     CLI(人與 CI)
  ├── server/mcp.ts       MCP(其他 agent)
  └── dsh-plugin/         DSH 斜線命令(設計師)
關鍵約束是 Figma 的雙沙箱:code.ts 有 figma.* 但沒有網路;ui.html 有 WebSocket 但沒有 figma.*。所以資料只能走 postMessage,這是架構的起點,不是選擇。
07技術棧與取捨
| 選擇 | 替代方案 | 為什麼選它 |
|---|---|---|
| SQLite(better-sqlite3,WAL) | Postgres / JSON 檔 | 單機、零維運;16 萬節點用 WAL 批次寫入仍是秒級;遞迴 CTE 可直接查子樹 |
| WebSocket relay | HTTP polling / 檔案落地 | plugin 不能寫本機檔案;批次串流需要 backpressure 與 ACK |
| TypeScript(無框架) | React / Vite / Prisma | 只有一個 iframe 與幾支 CLI;框架會讓「可重現」變難。stack lock 見 PLAN §0 |
| esbuild + tsx | webpack / ts-node | plugin 打包 18 KB、CLI 冷啟動 < 2 秒,夠用 |
| 手寫 MCP JSON-RPC | 官方 SDK | 只要三個方法;不新增依賴,核心可直接 import |
| DSH plugin(斜線命令) | 全走 MCP | 命令零 token、可常駐;MCP 每次呼叫都是外部進程 |
08三個關鍵設計
8.1 節點身份是結構 hash
每個節點的身份 = md5(type + 依序的子節點 hash)(Merkle 樹)。改名、複製、重排都不影響。
反面做法是拿名稱當 key——那會同時造成「同結構被拆散」與「不同結構被合併」,而且不會報錯。實測:27 個名稱 vs 68 種結構。
8.2 版面原型用 z-order,不用面積
彈窗的定義不是「面積小」,而是「畫面上蓋了一層遮罩」。所以規則是:
遮罩 = 與畫布同尺寸(±3px)
       + 這一層不含任何文字
       + 上方還有更小的兄弟節點(面板)
三個條件同時成立才算 overlay。早期只用面積,結果把首頁的 content(390×828,只比 844 少 16px)誤判成彈窗。
8.3 變體軸不做語意
「哪個 component 在成員之間切換、文案差在哪」是可計算的;「這叫做成功狀態」不是。工具只輸出前者,後者留給人。
這樣同一套程式碼換一個檔案仍然可用——它不需要先學會你的詞彙。
09資料契約
節點表格(節錄):
nodes(
  id TEXT PRIMARY KEY,        -- Figma node id
  parent_id TEXT,             -- 樹狀結構
  page_id TEXT, page_name TEXT,
  child_index INTEGER,        -- z-order(版面原型規則用這個)
  depth INTEGER, type TEXT, name TEXT,
  bbox_x/y/w/h REAL,
  layout_mode TEXT, layout_props_json TEXT,
  style_json TEXT,            -- fills / strokes / effects / cornerRadius
  text_content TEXT, text_style_json TEXT,
  bound_variables_json TEXT,  -- 變數綁定(設計系統採用率)
  main_component_id TEXT,     -- instance → component
  is_icon_container INTEGER DEFAULT 0
)
設計上的三個小心處:
- 不序列化向量幾何:改存
is_icon_container,避免 100 MB 的 path 資料 - 變數只存綁定,不存定義:library 變數不在檔案內,
variables表常常是空的 - 每批 500 筆 +
setTimeout(0):QuickJS 會凍結,這是硬需求
10三個入口,一個核心
| 入口 | 給誰 | 特性 |
|---|---|---|
npm run query -- <cmd> | 開發者 / CI | 唯讀、可 --json、錯誤有 code |
npm run mcp | 其他 agent | stdio JSON-RPC,11 個工具,跨 host 可用 |
/rea-figma-review | 設計師 | DSH 斜線命令,零 token、直接開看板 |
三個入口都只做「參數解析 + 排版」,所有計算在 server/core/。npm run test:parity 會把 CLI 的 JSON 輸出與 core 的結果逐位元比對——只要有人偷偷重算,測試就會紅。
11模型與 harness:用「夠好」的模型證明工程化有效
這個專案全程使用 DeepSeek V4.1 Flash,跑在 DSH(DeepSeek Harness) 上。它不是最頂尖的模型——這是刻意的選擇。
如果一個非頂尖模型在工程化之後能穩定完成任務,換上更強的模型只會更好;反過來,如果只靠模型能力而沒有工程約束,換模型也只是把不穩定換一種形式。
工程化做了什麼
- 型別化錯誤:五種 error code,不讓模型猜「哪裡錯了」
- 前置檢查:
doctor不過就不准開工 - 位元比對:
test:parity確認 CLI 與 core 完全一致 - 來源檢查:
verify-source確保每個 ID 都存在於樣本 - 契約化流程:
docs/SKILL.md每一步都有可觀察的通過條件
證據
| 測試 | 結果 |
|---|---|
| 42 個標註的版面原型判斷 | precision / recall 1.00 |
| 10 個節點實地抽查 | 10/10 與 Figma 一致 |
| 兩次冷啟動(新 agent 只讀 SKILL) | 皆完成流程;兩輪共補 15 個文件缺口 |
誠實的邊界:需要「理解設計意圖」的判斷(例如這頁算不算某個分類),模型仍然只能給候選。這個專案的做法是把不確定性外置——變成設計師按一下就能複審的清單。
12如何複現
# 1. 安裝
npm install

# 2. 起 ingestion server(會自動建立 data/rea-figma.sqlite)
npm run start:server

# 3. 建置並載入 Figma 插件
npm run build:plugin
#   Figma → Plugins → Development → Import plugin from manifest…
#   → plugin/manifest.json → 執行 → Extract AST to Local SQLite

# 4. 驗證環境與資料
npm run doctor
npm run audit:db -- ./data/rea-figma.sqlite

# 5. 建立樣本與查詢
npm run query -- sheet <node-id>
npm run sync            # 特徵表 → 預測 → 複審看板 → parity → 來源檢查
MCP 與 DSH plugin 的註冊方式見 docs/QUERY.md;每個設計決定的理由見 docs/DECISIONS.md。
13踩過的坑
這些都是實際發生、被測試抓到的問題。列出來是因為它們比「成功經驗」更有參考價值。
| 症狀 | 根因 | 解法 |
|---|---|---|
| 首頁被判定成彈窗 | 用面積猜遮罩;首頁的 content 是 390×828,只比 844 少 16px | 改成 z-order 規則:同尺寸 + 這一層無文字 + 上方有更小兄弟 |
| 同一頁面被拆成兩個家族 | 用圖層名稱當 key;27 個名稱對到 68 種結構 | 結構 Merkle hash;名稱降級為排序先驗 |
| 狀態字典換一個檔案就失效 | 把「成功/失敗」寫進核心 | 變體軸不做語意;語意留給標註層 |
| CLI 與 MCP 數字不同 | 兩邊各自實作同一段計算 | 抽 core;test:parity 逐位元比對 |
| apply 回報 3 列卻寫了 6 筆 | 新增的列同時計入 updated 與 added | 分開計數;計數對不上就停 |
| MCP 註冊後工具沒出現 | patch 檔要 - insert: 包住,不能直接給 id | 改用 insert 形式;日誌確認 reconnected and re-synced |
| 命令打了分類卻沒生效 | 命令輸入是非結構化文字,無法驗證 | 命令不吃參數;分類名由 agent 解析後回填 CLI |
| 28% 節點在目錄裡找不到 | page census 是獨立動作,reset 不清 pages | 查詢層改從 nodes 聚合;plugin 待修 |
每一個坑都對應一條現在寫在 docs/DECISIONS.md 或 docs/SKILL.md 的規則——規則不是憑空發明的,是被坑出來的。
14已知限制
| 限制 | 影響 |
|---|---|
| 沒有縮圖 | 複審看板用色票、型別比例、文案當視覺替代;要看真圖得回 Figma |
| kNN 分類 LOO 57% | 只有全票(86%)可作建議,其餘需人工 |
pages 目錄可能過期 | 查詢層一律從 nodes.page_name 聚合,不信任目錄表 |
| 語意分類需人工命名 | 工具給候選群,不給名字 |
這些限制寫在這裡,不是因為它們不重要,而是因為知道邊界在哪,才知道什麼時候不該用這個工具。
15深入解釋
如果你看到這裡想問「這是怎麼做到的?靠不靠譜?」——這五頁就是答案。從資料形狀開始,一層層講到工具契約。